Esta unidad
La Unidad 1 dejó la base pensada: qué es una base de datos, cómo se modela, qué son las tablas, las claves y las transacciones. Todo eso con palabras, diagramas y decisiones de diseño. Pero hasta ahora no se le pidió nada a la base.
Esta unidad es la que da el paso que faltaba: aprender a hablarle. El idioma se llama SQL, y con él se crean las tablas, se cargan los datos, se los busca, se los modifica y se los elimina. Es la herramienta con la que efectivamente se trabaja, y la que va a estar presente —por debajo— en todo lo que venga después.
El recorrido de la unidad sigue el orden natural de las cosas: primero el vocabulario y el terreno, después crear la estructura donde van los datos, después cargarlos, y al final sacarlos y cruzarlos. Las funciones de agregación y las consultas entre tablas amplían las preguntas que una base puede responder.
Antes de empezar hace falta un servidor andando. Todo lo que sigue se apoya en una misma idea: lo que se escriba se va a ejecutar de verdad, y una consulta no termina de entenderse hasta que aparece la grilla con las filas que devolvió. Ese servidor se instala junto con el resto del entorno: los pasos están en Anexo → XAMPP. Y la consola con la que se le va a hablar, phpMyAdmin, se explica más abajo, en Qué es phpMyAdmin.
La función de SQL
SQL (Structured Query Language, lenguaje de consulta estructurada) es el idioma con el que se le habla a una base de datos relacional. No corre en la computadora del usuario ni en el navegador: corre dentro del gestor, ahí donde están los datos. No hay otra puerta de entrada.
Es un estándar: desde mediados de los años ochenta existe una norma que define sus instrucciones básicas, y por eso lo que se aprende sirve casi igual en MySQL, MariaDB, PostgreSQL, SQL Server, Oracle o SQLite. Pero cada gestor tiene su dialecto —sus variantes, sus funciones propias— así que las consultas complejas no siempre se mudan de un gestor a otro sin retoques. Lo que se ve en esta unidad es el núcleo común.
Es un lenguaje declarativo
Esta es la diferencia más profunda con los lenguajes de programación que se aprenden habitualmente, y entenderla ahorra mucha confusión. En un lenguaje procedimental se escribe cómo hacer algo: recorrer una lista elemento por elemento, comparar cada uno, acumular un resultado. La receta paso a paso.
En SQL se escribe qué se quiere, y nada más:
SELECT nombre FROM socios WHERE localidad = 'La Plata';Esa sentencia dice «quiero los nombres de los socios que viven en La Plata». No dice cómo buscarlos, ni en qué orden revisar las filas, ni si conviene usar un índice. Eso lo decide el gestor. La comparación que mejor lo explica es la de la biblioteca: uno pide «las novelas de Cortázar publicadas después de 1960» y espera; no recorre los estantes uno por uno.
Y de ahí sale una consecuencia práctica que sorprende: la misma consulta puede tardar un segundo o un minuto según cómo estén armados los índices de la tabla, porque el camino lo elige el gestor. A eso se lo llama el plan de ejecución, y es la base de todo el trabajo de optimización.
Base de datos, tabla, campo y registro
Cuatro palabras que se usan todo el tiempo y que conviene fijar ahora, porque en SQL aparecen con nombres ligeramente distintos según el contexto. Los conceptos ya se vieron en la Unidad 1; acá interesa cómo se llaman cuando se escribe SQL.
| Concepto | Qué es | Otros nombres que vas a encontrar |
|---|---|---|
| Base de datos | El conjunto completo: todas las tablas de un sistema, con sus relaciones y sus reglas. | database, esquema |
| Tabla | Un conjunto de datos del mismo tipo, organizado en filas y columnas. | table, relación, entidad |
| Campo | Una de las columnas de la tabla. Define qué se guarda y de qué tipo. | columna, atributo |
| Registro | Una fila completa: un dato de cada campo, y todos referidos a lo mismo. | fila, tupla |
Vale detenerse en la última columna, porque no es un detalle académico. La documentación, los foros y los manuales usan los cuatro nombres indistintamente, y quien no sabe que son sinónimos pierde mucho tiempo creyendo que son cosas distintas. Cuando un manual dice «devuelve una tupla por cada atributo seleccionado», está diciendo en el fondo «devuelve una fila por cada columna que pediste».
Y hay una forma de la tabla que ayuda a no confundir campo con registro: el campo es la definición y el registro es el contenido. El campo nombre existe una sola vez y dice «acá va texto de hasta 80 caracteres». Los registros son todos los nombres distintos que hay cargados, uno por fila. Cuando se INSERT algo, no se agrega un campo: se agrega un registro.
Clave primaria y clave foránea
Las dos claves son las que convierten un conjunto de tablas sueltas en una base de datos relacional. Y en SQL tienen una forma concreta de escribirse, que es lo que interesa acá.
Clave primaria (PRIMARY KEY)
Es el campo —o el conjunto de campos— que identifica de manera única a cada registro de la tabla. No puede haber dos filas con la misma clave primaria, y no puede haber una fila sin clave. Es lo que permite decir «ese socio» sin ambigüedad.
id INT AUTO_INCREMENT PRIMARY KEYEn el ejemplo de la biblioteca, el documento podría haber sido la clave primaria —es único y obligatorio— pero se prefiere un campo propio: un número que asigna la base y que no depende de nada. El motivo es que cualquier dato del mundo real puede cambiar o puede estar mal cargado; un identificador que inventa el sistema, no.
Clave foránea (FOREIGN KEY)
Es un campo que señala a la clave primaria de otra tabla. Su función es guardar la relación: en lugar de repetir el nombre del socio en cada préstamo —y arriesgarse a escribirlo distinto cada vez— se guarda el id del socio.
socio_id INT NOT NULL,
FOREIGN KEY (socio_id) REFERENCES socios(id)
Lo que hace la clave foránea es hacer cumplir la relación: la base rechaza un préstamo cuyo socio_id no corresponda a ningún socio existente. Es decir, no se puede guardar una referencia a algo que no está. Esa garantía es el corazón del tema siguiente, la integridad referencial.
Tipos de datos: números, textos y fechas
En SQL, cada campo se declara con un tipo, y el tipo es lo que la base va a hacer respetar. Los tipos se agrupan en tres familias, y a cada familia le corresponden operaciones distintas:
| Familia | Tipos habituales | Qué se puede hacer con ellos |
|---|---|---|
| Números | INT, DECIMAL(10,2), FLOAT |
Sumar, promediar, comparar por mayor y menor, ordenar. |
| Textos | VARCHAR(n), CHAR(n), TEXT |
Comparar, buscar coincidencias, ordenar alfabéticamente, unir. |
| Fechas | DATE, TIME, DATETIME |
Calcular diferencias en días, filtrar por rango, ordenar cronológicamente. |
La elección del tipo se estudió en detalle en la Unidad 1. Desde el punto de vista de SQL, hay tres consecuencias que conviene tener presentes:
- El tipo decide qué se puede escribir. Un campo numérico rechaza el texto. Es la primera barrera contra los datos mal cargados, y actúa antes de que nos ocupemos nosotros.
- El tipo decide qué operaciones tienen sentido. Con fechas se puede calcular una diferencia de días; con texto, no. Si una fecha se guardó como texto, las cuentas no se pueden hacer.
- El tipo decide cómo se escribe el valor. Los textos y las fechas van entre comillas simples; los números, sin comillas. Es la causa más común de los errores de sintaxis.
Hay un detalle que vale desde el principio porque explica muchísimos errores posteriores: el tipo lo declara quien crea la tabla, pero lo respeta quien la usa. Si se declara DATE y después se guarda la fecha como si fuera texto, la base puede aceptarlo —según el gestor— y el dato queda inutilizable para calcular. El tipo es una promesa que hay que cumplir de los dos lados.
Cómo se escribe
SQL perdona casi todo lo que tiene que ver con el formato, y eso hace que las convenciones importen más que en otros lenguajes: una consulta se lee muchas más veces de las que se escribe.
| Convención | Ejemplo | Por qué |
|---|---|---|
| Palabras clave en mayúscula | SELECT, FROM, WHERE |
Separa el idioma de los nombres propios de la tabla. |
| Nombres en minúscula | socios, localidad |
Distinción inmediata entre instrucción y dato. |
| Punto y coma al final | ... = 'La Plata'; |
Es el separador real entre una sentencia y la siguiente. |
| Texto entre comillas simples | 'La Plata' |
Las comillas dobles tienen otro significado en SQL. |
| Una cláusula por renglón | SELECT y FROM en líneas distintas |
Se encuentra la cláusula buscada sin leer todo. |
| Comentarios | -- hasta el final · /* de bloque */ |
Dejan constancia de por qué se escribió así. |
Sobre los espacios y los saltos de línea hay algo que sorprende: no cambian nada. Una consulta se puede escribir en un renglón o repartida en diez, con más o menos sangría, y el resultado es idéntico. El único separador es el punto y coma. Por eso se puede «formatear» un texto SQL sin miedo: lo que se cambia es la legibilidad, no el significado.
Desde dónde se ejecuta
Hay tres lugares desde los que se le puede hablar a una base de datos, y conviene distinguirlos porque cumplen funciones muy distintas:
- Desde el gestor, con su consola de consultas: se escribe la sentencia y el resultado aparece en una grilla. Es donde se aprende y donde se prueba, y es el lugar de trabajo de toda esta unidad: en esta materia, phpMyAdmin.
- Desde la línea de comandos del gestor: sin ventanas, escribiendo el comando directamente. Se usa en servidores y en tareas automáticas.
- Desde una aplicación: el programa del servidor arma la sentencia y la ejecuta sin que nadie la escriba a mano. Es lo que se ve en la Unidad 4, y explica por qué el SQL de acá es la base de todo lo demás.
Vale aclarar algo que suele generar confusión: el usuario final de un sistema nunca escribe SQL. No sabe el idioma, no tiene por qué saberlo y no debería tenerlo cerca. Escribe su apellido en un casillero y aprieta un botón. El SQL es lo que hay del otro lado, y quien lo escribe es quien construye el sistema. Por eso esta unidad no es un tema «de programadores»: es el idioma del dato, y quien trabaja con datos necesita entenderlo aunque nunca vaya a escribir una consulta en producción.
Qué es phpMyAdmin
El gestor con el que se va a trabajar es phpMyAdmin: una consola web para administrar la base. No es una página más del sitio ni un programa que se instala aparte en la computadora: es una aplicación que vive en el servidor, al lado de la base de datos, y que se abre desde el navegador. En el entorno que se armó en el Anexo queda disponible en http://localhost/phpmyadmin.
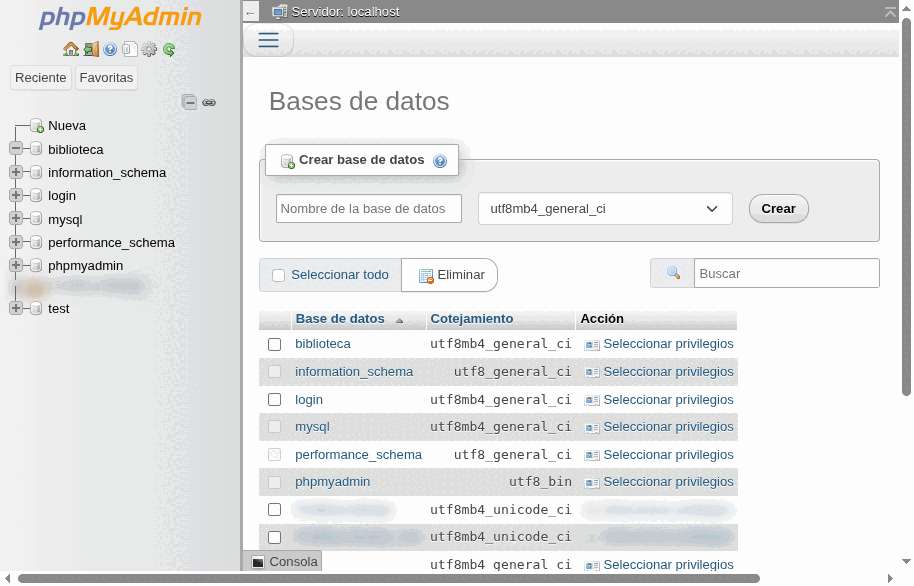
Lo importante es entender qué pasa cuando se hace clic. Cada pantalla de phpMyAdmin —la lista de tablas, el formulario que agrega una columna, el buscador— es una traducción a SQL de lo que se pidió. Se completa un formulario para agregar una fila y phpMyAdmin arma el INSERT y lo envía; se escribe una consulta en su caja de texto y la manda tal cual al servidor. Nunca deja de hablar SQL por debajo, y por eso sirve para aprender: se puede hacer la operación con el mouse y ver después qué consulta quedó.
En esta unidad se usa para tres cosas:
- Crear la base y las tablas, y ver el resultado de lo que se creó.
- Escribir las consultas en la caja de texto y ver la grilla que devuelven.
- Mirar los datos después de cargarlos, para comprobar que entraron como se esperaba.
Hay muchos otros gestores —de escritorio y en línea— y en la Unidad 4 se comparan. Acá alcanza con uno: el que viene instalado y el que se va a encontrar después en casi cualquier hosting donde se publique un sitio.
Crear la base de datos
Antes de escribir la primera tabla hace falta el recipiente donde van a ir: la base de datos. Es lo que se definió en Base de datos, tabla, campo y registro como el conjunto completo, todas las tablas de un sistema. Se crea una sola vez y después se trabaja adentro de ella.
- Abrir la consola. En el navegador, la dirección
http://localhost/phpmyadmin. - Entrar a «Bases de datos». En la barra de la parte de arriba hay una pestaña con ese nombre, y el formulario para crear una base nueva está ahí. El enlace Nueva del panel de la izquierda lleva al mismo lugar.
- Escribir el nombre. En el campo Nombre de la base de datos va
biblioteca: es el nombre que se va a usar en toda la unidad, porque sobre esa base están armados todos los ejemplos. - Dejar el cotejamiento como viene. El campo Cotejamiento dice cómo se comparan y se ordenan los textos: si las mayúsculas se distinguen de las minúsculas, cómo se ordenan los acentos, qué alfabetos se aceptan. El valor que propone phpMyAdmin,
utf8mb4_general_ci, sirve: acepta acentos, emojis y los alfabetos de casi cualquier idioma. - Apretar Crear. La base aparece en el panel de la izquierda, junto a las demás. No hay que guardar ni reiniciar nada: existe desde ese momento.
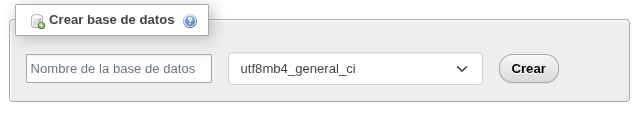
Para trabajar adentro de ella hay que seleccionarla: un clic en su nombre en el panel de la izquierda, y arriba aparecen las pestañas de esa base —Estructura, SQL y las demás—. Desde ahí ya se puede crear la primera tabla.
Como todo lo que hace phpMyAdmin por debajo es SQL, la misma operación se puede escribir a mano. Es la primera instrucción del año y conviene reconocerla:
CREATE DATABASE biblioteca
    CHARACTER SET utf8mb4
    COLLATE utf8mb4_general_ci;
Y para entrar en la base que se acaba de crear, sin volver a hacer clic en el nombre:
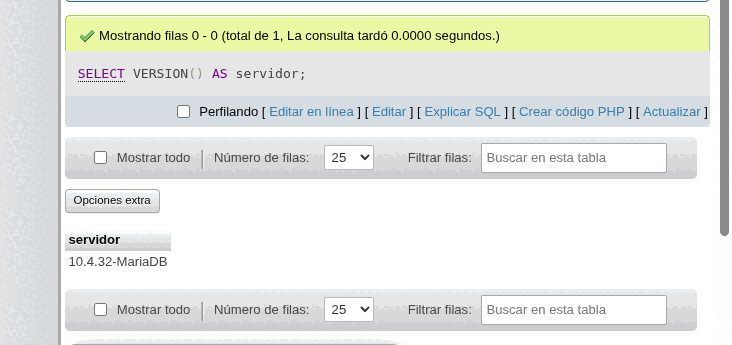
USE biblioteca;Para comprobar que quedó creada y que se puede consultar, se entra a su pestaña SQL y se le pide algo al servidor. Así se ve una consulta ejecutada: arriba lo que se escribió, abajo la grilla que devolvió.
Sobre el nombre hay tres reglas que conviene respetar desde el primer día, porque cambiarlo después obliga a corregir todo lo que lo menciona: todo en minúscula, sin espacios —se usa guion bajo— y sin acentos ni eñes. Por eso biblioteca, y no Biblioteca ni Biblioteca de la escuela.
Temas de la unidad
Después de esta introducción, las lecciones avanzan en orden: primero crear las tablas, después cargar datos y luego consultarlos, modificarlos y relacionarlos. Al final se dedica una página a la seguridad de esas consultas:
| Tema | Qué se ve |
|---|---|
| Creación de tablas | CREATE TABLE, las cuatro restricciones y la integridad referencial. |
| Carga de datos | INSERT INTO: uno o varios registros, y la correspondencia con los tipos. |
| Consultas básicas | SELECT y FROM, columnas específicas, alias con AS y DISTINCT. |
| Filtros y ordenamiento | WHERE con todos sus operadores, LIKE, BETWEEN, IN, valores nulos y ORDER BY. |
| Modificación y eliminación | UPDATE y DELETE, el peligro del WHERE olvidado y la verificación previa. |
| Funciones de agregación y agrupamiento | COUNT, SUM, AVG, MIN, MAX, GROUP BY y HAVING. |
| Consultas entre tablas | La relación mediante claves, INNER JOIN y el uso de alias. |
| Inyección SQL | Cómo un dato puede alterar una consulta y cómo evitarlo con consultas preparadas. |
| Ejercicios | Veinte bases de datos para diseñar, desde una tabla hasta cuatro, con la solución de cada uno. |
La agregación y las consultas entre tablas amplían lo que se puede preguntar. Primero se trabaja dentro de una tabla: cargar, buscar y corregir. Con la agregación se resume mucha información en un número; con las consultas entre tablas se combinan datos para responder preguntas que ninguna tabla puede contestar sola.
Resumen
- Esta unidad es la que enseña a hablarle a la base de datos: el idioma es SQL.
- SQL corre dentro del gestor, es un estándar y cada gestor tiene su dialecto.
- Es declarativo: se dice qué se quiere, no cómo conseguirlo. El gestor elige el camino.
- El vocabulario: base de datos, tabla, campo y registro. Campo = columna = atributo; registro = fila = tupla.
- El campo es la definición y el registro es el contenido.
- La clave primaria identifica de manera única a cada registro; la clave foránea señala la de otra tabla.
- Los tipos se agrupan en números, textos y fechas, y deciden qué se puede escribir y qué se puede calcular.
- Convenciones: palabras clave en mayúscula, nombres en minúscula, texto entre comillas simples, punto y coma al final.
- Los espacios y los saltos de línea no cambian el resultado.
- El SQL se puede ejecutar desde el gestor, desde la consola o desde una aplicación. El usuario final nunca lo escribe.
- phpMyAdmin es la consola web desde la que se trabaja: cada clic que se hace ahí termina siendo una consulta SQL.
- Antes de las tablas hay que crear la base de datos, que es el recipiente donde van. En el ejemplo de la unidad se llama
biblioteca.