La relación mediante claves
En el tema 2 se crearon las tablas con sus claves foráneas, y quedó dicho que una clave foránea señala a la clave primaria de otra tabla. Esa relación existe en el diseño, y el gestor la hace cumplir: rechaza un préstamo cuyo socio no exista.
Pero una relación declarada no sirve de nada si no se puede usar para consultar. La clave foránea dice que prestamos.socio_id apunta a socios.id; lo que falta es la forma de aprovechar ese dato para responder preguntas que mezclan las dos tablas. De eso trata este tema, que cierra la unidad.
Es el paso que convierte una base de datos en un sistema que puede responder preguntas. Mientras se trabaja dentro de una sola tabla se puede cargar, buscar, corregir y resumir. Cruzando tablas se puede responder lo que de verdad se le pregunta a un sistema: quién se llevó qué, qué cliente compró qué producto, qué alumno cursó qué materia.
Por qué no alcanza una tabla
La pregunta es concreta: «¿qué libros sacó Ana Pérez?». Y no hay ninguna tabla que pueda contestarla sola:
| Tabla | Qué tiene guardado | Qué le falta para responder |
|---|---|---|
prestamos |
Qué libro se llevó cada socio y cuándo, pero el socio aparece como un número: socio_id = 47. |
El nombre. Dice «el 47», no «Ana Pérez». |
socios |
El nombre, el documento y el correo de cada socio. | Los préstamos. No hay ninguna referencia a libros. |
Esa separación es a propósito, y es exactamente lo que se buscó con la normalización de la Unidad 1: no repetir el nombre del socio en cada préstamo, porque repetido se escribe distinto cada vez y hay que corregirlo en cien lugares. Se paga un precio —hay que cruzar dos tablas para responder— y el precio vale la pena.
La solución no es guardar el nombre también en prestamos. Eso resolvería esta consulta y arruinaría el diseño: habría dos versiones del nombre de la misma persona, y el día que difieran, ninguna de las dos sería la verdadera. Lo que hace falta es combinar las dos tablas en el momento de consultar, y para eso está JOIN.
Combinación de tablas con INNER JOIN
La instrucción se escribe así:
SELECT     s.nombre, s.documento, p.salida
FROM       prestamos AS p
INNER JOIN socios    AS s ON s.id = p.socio_id
ORDER BY   p.salida DESC;
Y se lee como una frase: «de los préstamos, combinados con los socios según la condición s.id = p.socio_id, dame el nombre del socio, su documento y la fecha del préstamo». La parte que hace todo el trabajo es el ON: dice cómo se empareja un registro de una tabla con un registro de la otra. En la enorme mayoría de los casos, esa condición es la clave foránea igual a la clave primaria.
El modelo mental que conviene tener: la base toma cada registro de la primera tabla, busca en la segunda los registros que cumplen el ON, y arma con ellos un registro combinado que tiene las columnas de las dos. Los registros combinados son los que devuelve la consulta.
JOIN sin ON empareja todo con todo. Si se olvida la condición, la base no puede saber qué va con qué, así que combina cada registro de una tabla con cada registro de la otra. Con cien préstamos y cincuenta socios, el resultado tiene cinco mil filas, todas sin sentido. No hay error y tampoco es lento: sale. Lo que sale es cualquier cosa. Al resultado se lo llama producto cartesiano, y es la señal de que falta la condición.
Cuando hacen falta tres tablas, se encadenan los JOIN, uno por cada relación que haya que seguir:
SELECT     s.nombre, l.titulo, p.salida
FROM       prestamos AS p
INNER JOIN socios    AS s ON s.id = p.socio_id
INNER JOIN libros    AS l ON l.id = p.libro_id
ORDER BY   p.salida DESC;
Dos detalles de escritura. INNER JOIN y JOIN son exactamente lo mismo: INNER se puede omitir, y de hecho casi todo el mundo lo omite. Y existe una forma vieja de hacer lo mismo, con las tablas separadas por comas y la condición escondida en el WHERE —FROM prestamos p, socios s WHERE s.id = p.socio_id—. Funciona, y aparece mucho en código antiguo, pero conviene evitarla: mezcla la condición de emparejamiento con la de filtrado, y con tres o cuatro tablas ya no se sabe cuál es cuál. El JOIN explícito dice cada cosa en su lugar.
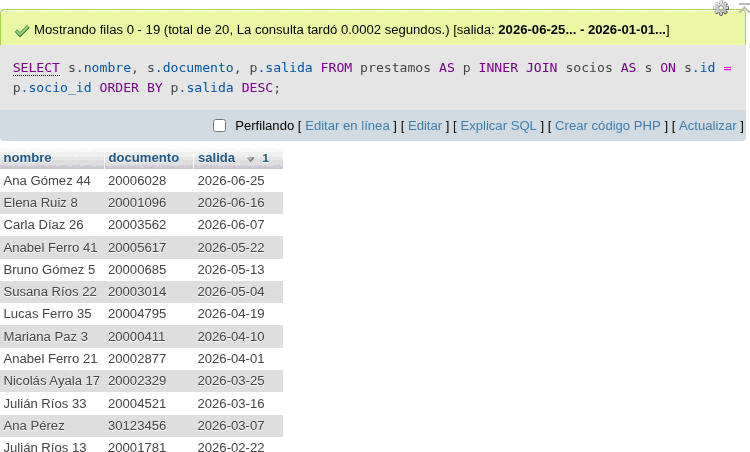
ON reemplaza al socio_id por el nombre y el documento. Es la consulta que ninguna de las dos tablas podía responder sola.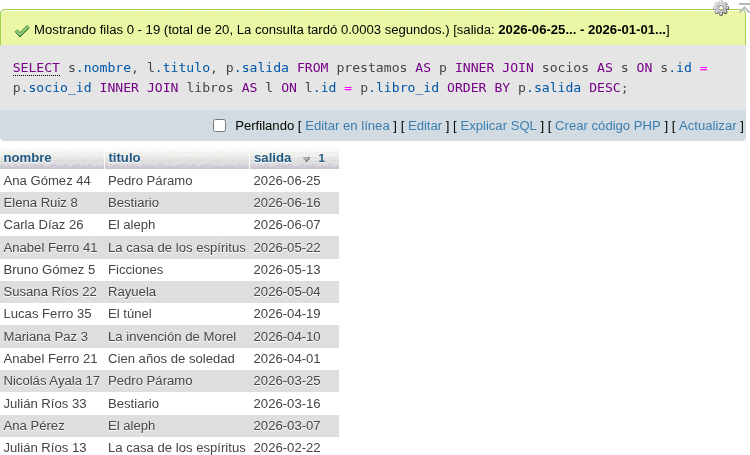
JOIN aparece el título del libro. Tres tablas, dos condiciones y una sola grilla.Uso de alias para tablas y columnas
En los ejemplos aparecieron p y s después de AS. Son alias de tabla, y en una consulta con más de una tabla dejan de ser una comodidad para volverse necesarios:
- Evitan la ambigüedad. Las dos tablas tienen un campo
id. Si se escribeSELECT id, la base no puede saber de cuál habla, y la consulta falla con un error de campo ambiguo. Hay que decirs.idop.id. - Acortan.
p.salidase lee mejor queprestamos.salida, y en una consulta con tres tablas la diferencia es notable. - Se usan en todas las cláusulas. Una vez definido el alias, hay que usarlo consistentemente: en el
SELECT, en elON, en elWHEREy en elORDER BY.
El alias de tabla vive solo en la consulta: no renombra nada en la base de datos, igual que el alias de columna. Y vale una recomendación de estilo: los alias cortos son útiles, pero tienen que sugerir la tabla. s de socios y p de prestamos se entienden; a, b y c obligan a volver al FROM cada vez que se lee una línea. Los alias de columna con AS, que se vieron en las consultas básicas, se combinan sin problema: SELECT s.nombre AS socio, COUNT(*) AS libros.
Qué queda afuera del INNER JOIN
Hay algo que conviene entender bien, porque es la causa de la mitad de los resultados que «faltan datos». El INNER JOIN devuelve solo los registros que tienen pareja en las dos tablas. El que no la tiene, no aparece. Ni como error, ni como fila vacía: simplemente no está.
Con la biblioteca, eso significa tres cosas:
- Un socio que nunca sacó un libro no aparece en la consulta de préstamos, porque no hay ningún préstamo que lo traiga.
- Un libro que nunca se prestó, tampoco.
- Y un préstamo cuyo
socio_idapuntara a un socio inexistente quedaría afuera también —aunque eso no puede pasar, porque la integridad referencial lo impide—.
Entonces, la pregunta «¿qué socios nunca sacaron un libro?» no se puede responder con INNER JOIN, y la razón es casi filosófica: los que se buscan son exactamente los que no tienen coincidencia, y el INNER JOIN está hecho para quedarse con los que sí la tienen. Para esos casos existe LEFT JOIN, que conserva los registros de la tabla de la izquierda aunque no tengan pareja, y deja vacíos los campos de la otra tabla. No es tema de esta unidad, pero conviene saber que existe y, sobre todo, saber que la ausencia de un registro en un resultado cruzado no siempre significa que el dato no esté: muchas veces significa que el tipo de combinación lo dejó afuera.
Archivos para practicar
Todo lo que se explica en esta página se puede probar de verdad, sin copiar y pegar sentencia por sentencia. Cada archivo crea su propia base, con las tablas y los datos ya cargados, y trae al final —comentadas— las consultas para practicar.
| Archivo | Descargar | Qué trae |
|---|---|---|
biblioteca_2_tablas.sql |
Descargar | localidades y socios: dos tablas con una clave foránea, para practicar el JOIN de dos tablas y el LEFT JOIN. |
biblioteca_3_tablas.sql |
Descargar | socios, libros y préstamos: tres tablas con dos claves foráneas, para el JOIN encadenado. Trae un socio sin préstamos y un libro que nunca se prestó, que son los casos donde se ve la diferencia con el LEFT JOIN. |
Cómo se importa
Importar es abrir el archivo .sql dentro del gestor para que él ejecute todas las sentencias de una sola vez. Son cuatro pasos, y son siempre los mismos:
- Descargar el archivo desde la tabla de arriba y fijarse dónde quedó: casi siempre, en la carpeta Descargas.
- Abrir phpMyAdmin —en XAMPP, el botón Admin que está en la fila de MySQL— y entrar a la pestaña Importar, la que está arriba de todo.
- Elegir el archivo con el botón Seleccionar archivo. No hace falta crear antes la base de datos: el archivo la crea.
- Apretar Importar y esperar el mensaje verde: «La importación se ha finalizado correctamente».
Si el mensaje es verde, ya está: la base aparece en la lista de la izquierda, con sus tablas y con los datos cargados. Si sale en rojo, phpMyAdmin dice en qué línea del archivo se trabó, y las dos causas más comunes son que la base ya existía o que el archivo se cortó al descargarse.
Cuidado con el nombre de la base. Al importar, cada archivo borra la base con ese nombre si ya existía y la vuelve a crear vacía. Es lo que permite repetir la práctica todas las veces que haga falta —siempre arranca igual—, pero también significa que no conviene guardar datos propios en una base que se llame biblioteca_1_tabla, biblioteca_2_tablas o biblioteca_3_tablas.
Resumen
- Las tablas se relacionan por claves foráneas, y esa relación se usa al consultar.
- Una sola tabla no puede responder preguntas que mezclan datos de dos:
prestamosdice «el 47», no «Ana Pérez». - Esa separación es a propósito: es lo que se buscó con la normalización.
- La solución no es duplicar el dato, sino combinar las tablas al consultar.
FROM a INNER JOIN b ON condición: elONdice cómo se emparejan los registros.- Casi siempre el
ONes clave foránea igual a clave primaria. - Un
JOINsinONda el producto cartesiano: cada registro con cada uno del otro lado. - Para tres tablas se encadenan los
JOIN, uno por relación. INNER JOINyJOINson lo mismo.- Los alias de tabla evitan la ambigüedad —las dos tablas tienen
id— y acortan. Conviene que sugieran la tabla. - El
INNER JOINdeja afuera los registros sin pareja: un socio sin préstamos no aparece. - Para los que no tienen pareja existe
LEFT JOIN.