Qué son las funciones de agregación
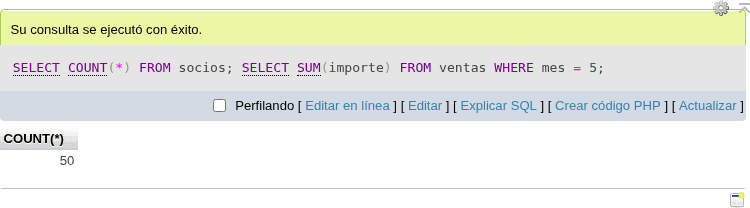
Todas las consultas de los temas anteriores devolvían registros: una lista de filas, más larga o más corta, pero siempre una lista. Las funciones de agregación cambian eso por completo: devuelven un solo valor que resume muchos registros.
SELECT COUNT(*) FROM socios;   -- un número: cuántos socios hay
SELECT SUM(importe) FROM ventas WHERE mes = 5;   -- un número: cuánto se vendió en mayo
La diferencia es de perspectiva, y es la más importante de la unidad. Hasta acá la pregunta era «mostrame los datos». Con agregación la pregunta pasa a ser «resumime los datos». Y son dos preguntas distintas: ver la lista de las trescientas ventas del mes no dice cuánto se vendió; hay que sumarlas. La función de agregación hace esa suma —o ese conteo, o ese promedio— en la base, y devuelve el número ya calculado.
Hay una forma de verlo que ayuda a entender todo lo que sigue, incluido el agrupamiento: la agregación colapsa los registros. Trescientos registros entran a la función y sale un solo valor. Y el tema siguiente —GROUP BY— es la forma de que ese colapso ocurra varias veces, una por cada grupo, en lugar de una sola vez para toda la tabla.
COUNT, SUM, AVG, MIN y MAX
Son las cinco del programa, y cada una responde una pregunta distinta:
| Función | Qué devuelve | Ejemplo |
|---|---|---|
COUNT(*) | Cuántos registros hay. | SELECT COUNT(*) FROM socios; |
COUNT(campo) | Cuántos registros tienen ese campo con dato. | SELECT COUNT(correo) FROM socios; |
SUM(campo) | La suma de todos los valores. | SELECT SUM(importe) FROM ventas; |
AVG(campo) | El promedio. | SELECT AVG(precio) FROM productos; |
MIN(campo) | El valor mínimo. | SELECT MIN(alta) FROM socios; |
MAX(campo) | El valor máximo. | SELECT MAX(importe) FROM ventas; |
El MIN y el MAX no sirven solo para números: aplicados a una fecha dan el más antiguo y el más reciente —que es una pregunta que aparece todo el tiempo— y aplicados a un texto dan el primero y el último según el orden alfabético. Y se pueden combinar varias funciones en una misma consulta:
SELECT COUNT(*)                  AS cantidad,
       MIN(importe)              AS menor,
       MAX(importe)              AS mayor,
       ROUND(AVG(importe), 2)    AS promedio
FROM ventas;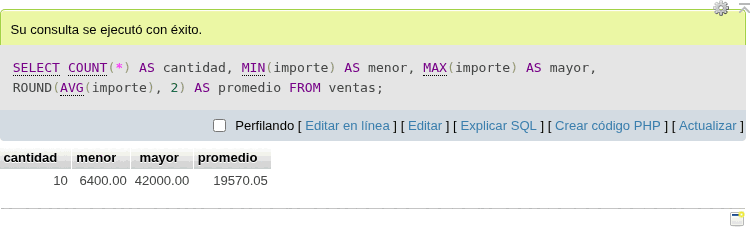
La diferencia entre COUNT(*) y COUNT(campo)
Es la distinción más útil de todo el tema y la que más se pasa por alto. COUNT(*) cuenta registros, estén como estén. COUNT(campo) cuenta solo los registros donde ese campo tiene un dato, porque las funciones de agregación ignoran los NULL.
SELECT COUNT(*)                          AS socios_cargados,
       COUNT(correo)                     AS con_correo,
       COUNT(*) - COUNT(correo)          AS sin_correo
FROM socios;
Eso convierte a COUNT(campo) en una herramienta de control de calidad: es la forma más rápida de saber cuántos registros tienen un campo vacío. Y explica el otro error clásico, el del promedio.
NULL, y eso cambia el resultado. AVG(precio) no divide por la cantidad de registros: divide por la cantidad de registros que tienen precio cargado. Si de cien productos veinte no tienen precio, el promedio se calcula sobre ochenta. Y eso puede ser exactamente lo que se quiere —un producto sin precio no tiene por qué arrastrar el promedio hacia abajo— o puede ser un error de interpretación grave: el promedio «de todos los productos» no es ese número. Lo mismo vale para SUM, MIN y MAX. Antes de confiar en un promedio, conviene comprobar con COUNT(*) cuántos registros son y con COUNT(campo) sobre cuántos se calculó.
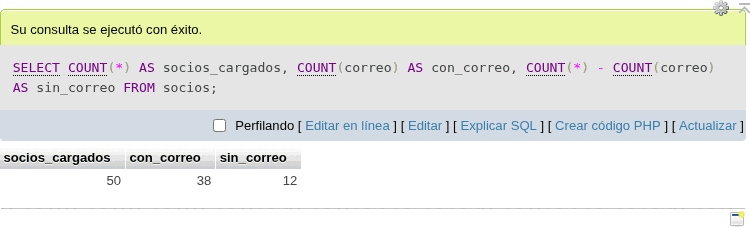
COUNT(correo) no habría contado a esos doce.Agrupamiento con GROUP BY
Una agregación sin agrupar devuelve un solo total para toda la tabla. Casi siempre lo que se necesita es otra cosa: un total por cada grupo. Cuántos socios hay en cada localidad, no cuántos socios hay en total. Eso es GROUP BY.
SELECT   localidad, COUNT(*) AS cantidad
FROM     socios
GROUP BY localidad
ORDER BY cantidad DESC;
Lo que hace GROUP BY localidad es partir los registros en montones, uno por cada localidad distinta, y después aplicar la función dentro de cada montón. El resultado tiene tantas filas como localidades haya. Sin GROUP BY habría una sola fila; con él, una por grupo.
GROUP BY. En el ejemplo se muestran localidad y COUNT(*): localidad está agrupada y COUNT es una función, así que la consulta es correcta. Si se agregara nombre al SELECT sin agruparlo, la consulta pediría algo imposible: no hay un solo nombre por localidad, hay muchos, y la base no tiene forma de elegir uno. Según el gestor y su configuración, eso da un error —es lo más probable en versiones actuales— o, peor, devuelve un nombre cualquiera sin avisar. La regla es fácil de recordar y no falla: lo que se muestra es o parte del grupo o resultado de una función.
Se puede agrupar por más de un campo, y entonces el grupo es la combinación de los dos: GROUP BY localidad, activo devuelve una fila por cada par de localidad y estado, es decir, la cantidad de activos y de inactivos de cada localidad. Y conviene tener presente que el orden de GROUP BY no está garantizado, igual que pasaba sin agrupar: si se quiere la lista ordenada, hace falta el ORDER BY, como en el primer ejemplo.
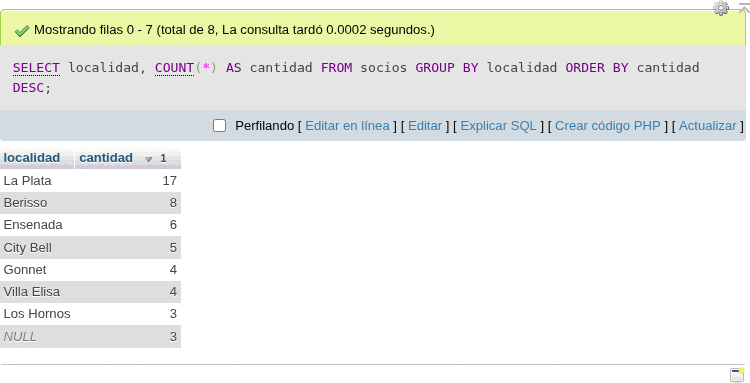
NULL es la de los socios sin localidad cargada: el agrupamiento los junta a todos en un grupo propio.Filtrado de grupos con HAVING
Con los grupos armados aparece una pregunta nueva: «¿y si solo quiero los grupos que cumplen algo?». Las localidades con más de diez socios, los meses en que se vendió más de un millón. La respuesta natural sería un WHERE, y ahí está el problema:
-- NO funciona: el WHERE se aplica antes de agrupar,
-- así que todavía no existe ningún COUNT que comparar.
SELECT localidad, COUNT(*) AS cantidad
FROM   socios
WHERE  COUNT(*) > 10
GROUP BY localidad;
WHERE filtra registros, y actúa antes de que se armen los grupos. Cuando el WHERE se evalúa, el COUNT todavía no existe: no se puede preguntar por algo que no está calculado. Para eso está HAVING, que filtra grupos y actúa después del agrupamiento:
SELECT   localidad, COUNT(*) AS cantidad
FROM     socios
GROUP BY localidad
HAVING   COUNT(*) > 10
ORDER BY cantidad DESC;
WHERE |
HAVING |
|
|---|---|---|
| Qué filtra | Registros, uno por uno. | Grupos, ya armados. |
| Cuándo se aplica | Antes de agrupar. | Después de agrupar. |
| Puede usar funciones | No. El COUNT todavía no existe. | Sí. Es su razón de ser. |
| Ejemplo | WHERE activo = 1 | HAVING COUNT(*) > 10 |
Decidir cuál usar se resuelve con una pregunta: ¿la condición habla de un dato del registro o del resultado de una función? Si dice «los socios activos», es un dato de cada registro y va en WHERE. Si dice «las localidades con más de diez socios», habla de un total, y va en HAVING. Y si la condición se puede poner en el WHERE, conviene ponerla ahí: filtrar antes de agrupar significa que la base trabaja con menos registros, y eso es más rápido.
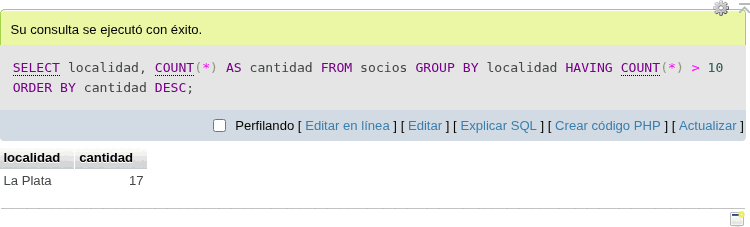
HAVING filtra los grupos ya armados: de las ocho localidades queda solo La Plata, con sus 17 socios. Los grupos de pocos integrantes no llegaron al resultado.WHERE y HAVING juntos
Las dos cláusulas conviven sin problema, y una consulta un poco más real las usa a las dos. Este es el orden en que se escriben:
SELECT   localidad, COUNT(*) AS cantidad
FROM     socios
WHERE    activo = 1
GROUP BY localidad
HAVING   COUNT(*) > 10
ORDER BY cantidad DESC;
Se lee así: «de los socios activos, agrupados por localidad, mostrame las localidades que tengan más de diez, ordenadas de mayor a menor». Y el orden en que están escritas las cláusulas no es el orden en que la base las resuelve. El orden de resolución es:
| Paso | Cláusula | Qué pasa |
|---|---|---|
| 1 | FROM | Se ubica la tabla. |
| 2 | WHERE | Se descartan los registros que no cumplen. |
| 3 | GROUP BY | Los que quedan se parten en grupos. |
| 4 | HAVING | Se descartan los grupos que no cumplen. |
| 5 | SELECT | Recién ahora se arma la lista de columnas. |
| 6 | ORDER BY | Se ordena el resultado. |
Ese orden explica casi todas las rarezas que desconciertan cuando se empieza. Explica por qué un alias definido en el SELECT no se puede usar en el WHERE —cuando el filtro se evalúa, el alias no existe todavía— pero sí se puede usar en el ORDER BY, que es el último paso. Explica por qué el WHERE no puede usar funciones de agregación y el HAVING sí. Y explica por qué conviene filtrar todo lo posible en el WHERE: los registros que se descartan temprano no llegan a agruparse.
Resumen
- Las funciones de agregación devuelven un solo valor que resume muchos registros.
- Las cinco son
COUNT,SUM,AVG,MINyMAX. MINyMAXtambién sirven con fechas y con textos.COUNT(*)cuenta registros;COUNT(campo)cuenta solo los que tienen dato.- Todas las funciones ignoran los
NULL, y por eso el promedio se calcula sobre los que tienen valor. GROUP BYparte los registros en grupos y aplica la función en cada grupo.- Lo que se muestra es o parte del grupo o resultado de una función.
WHEREfiltra registros antes de agrupar;HAVINGfiltra grupos después.- Solo
HAVINGpuede usar funciones de agregación. - Se escribe
SELECT … FROM … WHERE … GROUP BY … HAVING … ORDER BY, pero se resuelve en otro orden. - Conviene filtrar en el
WHEREtodo lo posible: los registros descartados temprano no se agrupan.